


2023年,说到“ AI ”,大多数人会想到 ChatGPT。如今,2025年的 AI 世界已大不相同。虽然 LLM(大型语言模型)点燃了 AI 革命的火花,但现在我们正迈入一个由多种专门 AI 模型主导的时代,每种模型都有其独特的“超能力”。
然而,很多人仍将所有 AI 模型统称为“ LLM ”,就像把自行车、卡车和飞机都叫“汽车”一样。虽然它们都能“动”,但用途却截然不同。
无论你是 AI 研究员、创业者、产品经理,还是对科技感兴趣的普通人,了解 LLM、LAM、SLM、MoE 等模型的区别已不再是锦上添花,而是竞争的关键优势。
以下,我们将为你拆解 2025 年最值得关注的 8 种 AI 模型类型,带你看清它们的独特之处和应用场景。
1. LLM —— 大型语言模型
LLM 究竟是什么?
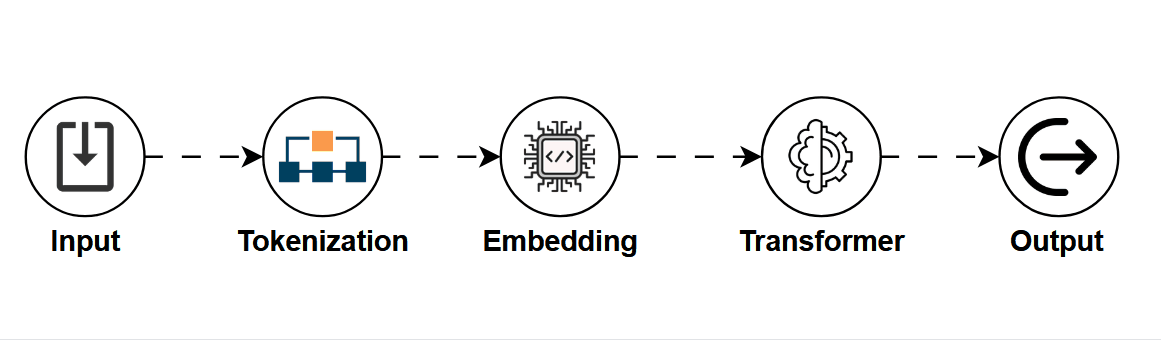
想象一个超级聪明的朋友,能接上你的话、写长篇论文、调试代码,甚至模仿莎士比亚的风格。这就是 LLM( Large Language Model )。它们通过海量文本数据(互联网、书籍、文章、代码、社交媒体等)训练,学会预测句子中的下一个单词或符号。
简单来说,LLM 就像一个超级强大的“自动补全”工具,不仅能完成句子,还能写书、回答哲学问题,甚至生成一个可运行的网站。
为什么 LLM 如此火爆?
- 对话能力:ChatGPT、Claude、Gemini 等都由 LLM 驱动,擅长自然对话。
- 多才多艺:从博客写作到 Python 编程,LLM 能胜任创意和技术任务。
- 广博知识:它们几乎“无所不知”,是通用知识的理想工具。
应用场景
- 内容创作与改写
- 编程辅助与代码生成
- 客服聊天机器人
- 头脑风暴与创意生成
- 语言翻译
- 教育辅导
局限性
尽管 LLM 看似神奇,但也有短板:
- 可能“幻觉”(自信地胡编乱造)
- 计算成本高,运行昂贵
- 缺乏真正理解,仅靠模式猜测
因此,更多专为速度、特化或深度推理设计的模型正在迅速崛起。
2. LCM —— 潜在一致性模型
LCM 是什么?为什么重要?

想象你在手机上使用 AI 图像生成器,只需不到一秒,就能得到一张清晰的图片,无需云端连接。这就是 LCM( Latent Consistency Model )的魅力。
LCM 专为图像生成设计,注重速度、效率和在小型设备上的运行。它们是 Stable Diffusion 等重量级图像模型的轻量级“表亲”,适合在手机或边缘设备上快速生成图像。
工作原理
LCM 基于扩散模型( Diffusion Model ),通过逐步“去噪”将随机模式转化为有意义的图像。但与传统模型需要几十步不同,LCM 在压缩的“潜在空间”中学习一致性模式,极大缩短生成过程。就像画一张脸,普通模型需要画50条线,LCM 只需几笔就能完成。
应用场景
- 设备端图像生成(如 AI 滤镜、头像)
- AR/VR 应用,强调实时性
- 设计师快速原型工具
- 智能摄像头实时视觉增强
2025年的意义
随着边缘计算的兴起,设备本地生成内容的需求激增。LCM 助力快速、隐私保护的图像处理,未来你的智能眼镜或手表可能都会用 LCM 实时生成或增强图像。
3. LAM —— 语言行动模型
LAM 是什么?

如果说 LLM 是能聊天的朋友,LCM 是快速作画的艺术家,那么 LAM( Language Action Model )就是能计划、记忆和执行任务的智能助理。
LAM 不仅理解语言,还能识别意图、记住上下文,并与工具或环境互动。它们是 AI 代理的支柱,能自动化任务、操作软件或规划复杂行动,如订机票或调试代码。
工作原理
LAM 通常结合以下模块:
- LLM 处理自然语言理解
- 记忆模块跟踪历史动作或输入
- 规划器分解复杂任务
- 工具使用能力通过 API 或接口执行步骤
例如,你说:“帮我订去东京的机票,比较酒店价格,提醒我签证预约。”普通 LLM 可能只给出建议,而 LAM 会实际操作,查询日历、调用 API 并生成任务流程。
应用场景
- 自动化工作流(如 Zapier AI、Devin)
- 数字助理与应用交互
- 解决问题的客服机器人
- 基于指令完成任务的生产力工具
- 机器人通过语言指令控制物理动作
2025年的意义
LAM 将 AI 从“理解”推向“行动”,在自动化日益增长的世界中,它们能跨应用工作、理解长期目标并适应环境变化。想象一个 AI 不仅能起草邮件,还能发送、跟进并安排会议——这一切仅需一个指令。
4. MoE —— 专家混合模型
MoE 是什么?

想象你问一个复杂问题,不是找一个通才回答,而是由一群专家分工协作。这就是 MoE( Mixture of Experts )模型的精髓。
MoE 由多个子模型(“专家”)组成,但每次处理输入时,只激活少数相关专家。这让模型高效、可扩展,因为并非所有专家都需同时工作。就像为手术找最好的外科医生、为烹饪找顶级厨师,MoE 在一个 AI 中整合多领域专长。
工作原理
MoE 依赖一个“路由器”系统:
- 评估输入
- 选择最相关的几个专家(比如100个中选2个)
- 仅激活这些专家处理输入
- 合并输出返回给用户
这种方式以最小的计算开销提供精准智能。
应用场景
- 高性能大规模 AI(如 Google 的 Switch Transformer、GShard)
- 高效云推理,节省资源
- 领域特化助手(如医疗或法律专家)
- 多语言系统,不同语言由不同专家处理
- 个性化定制,根据用户行为调优
2025年的意义
随着 AI 模型参数量达到千亿级,计算成本成为瓶颈。MoE 通过只激活必要部分,实现性能飞跃而无需超级计算机。它们还支持模块化扩展,可轻松添加新专家而无需重新训练整个模型。
5. VLM —— 视觉语言模型
VLM 是什么?
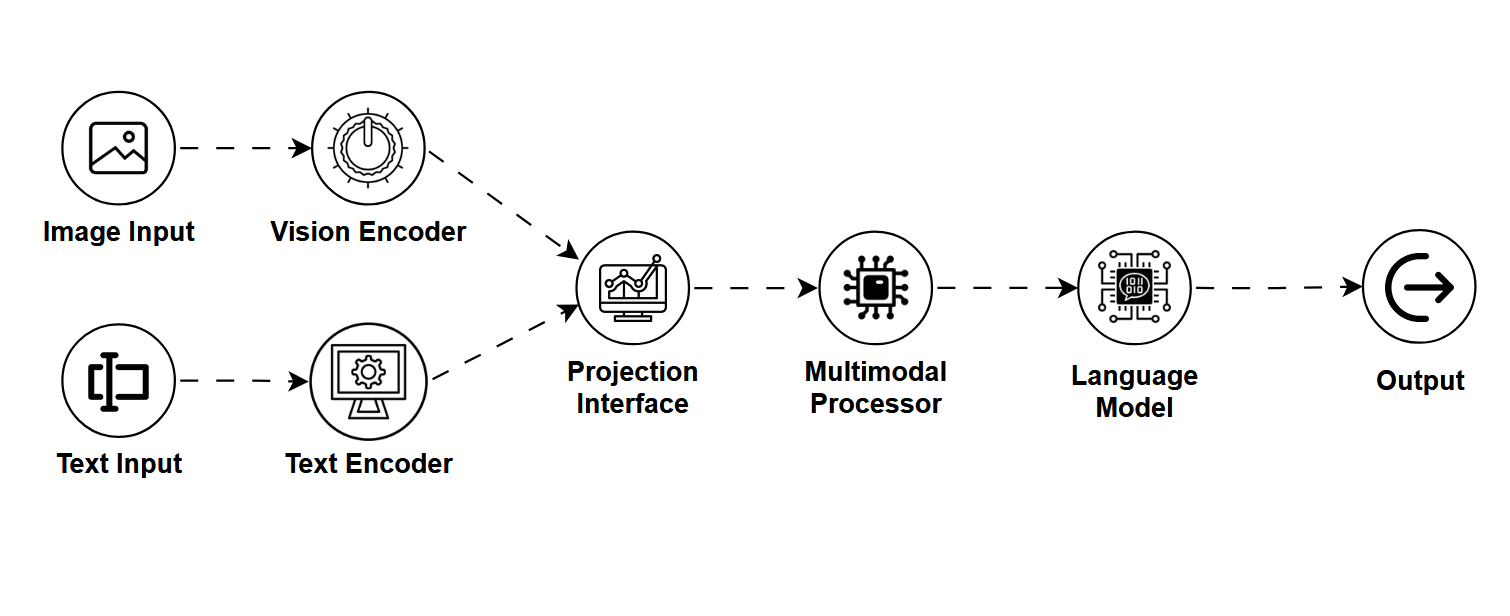
想象一个 AI 能看懂图片、理解你的文字描述,然后给出深入的回应。这就是 VLM( Vision Language Model )的魔力。它们能同时处理视觉和文本输入,堪称 AI 的“瑞士军刀”。
工作原理
VLM 的核心是一个共享嵌入空间,将图像和文本映射为相似的“含义”表示:
- 图像通过视觉编码器(如 Transformer 或 CNN)处理
- 文本通过语言编码器(如 BERT 或 GPT)处理
- 两者在共享潜在空间对齐,实现跨模态理解
- 输出包括回答、描述、分类等
例如,你上传一张破损手机屏幕的照片并问:“还能用吗?” VLM 能分析图像、理解问题并给出实用建议。
应用场景
- 多模态助手(如 ChatGPT-4o、Gemini)
- 图像描述生成
- 视觉问答( VQA )
- 支持文本和图像的搜索引擎
- 无障碍工具(如为视障用户描述图像)
- 机器人通过视觉和指令理解环境
2025年的意义
在视觉内容日益主导的数字世界,VLM 连接了语言驱动的界面与视觉优先的现实,适用于多模态搜索、情境感知代理和实体 AI 系统。它们让 AI 更直观、更贴近人类需求。
6. SLM —— 小型语言模型
SLM 是什么?

当 LLM 以庞大规模抢占风头时,SLM( Small Language Model )在手机、笔记本甚至智能烤面包机上默默发力。SLM 是紧凑高效的语言模型,专为低延迟、有限硬件设计。
它们是 LLM 的“极简表亲”,计算需求低但功能依然强大。
工作原理
SLM 采用与 LLM 类似的 Transformer 架构,但参数量少(百万级而非数十亿),并通过量化、剪枝或知识蒸馏优化,适合边缘设备(如手机、物联网)、浏览器或本地服务器部署。
应用场景
- 设备端聊天机器人(如手机虚拟助手)
- 智能家电和嵌入式系统
- 隐私优先应用(数据无需离开设备)
- 开发者工具和本地 IDE 代码补全
- 机器人或 AR 头显实时推理
例如,你的智能电视能立刻回答“有什么像《星际穿越》一样的电影?”无需连接云端,这就是 SLM 的功劳。
2025年的意义
随着 AI 融入日常生活,对低延迟、节能和隐私保护模型的需求激增。SLM 实现:
- 离线智能,无需网络
- 数据主权,保护隐私
- 可扩展部署,从手机到智能电表
像 Phi-3、TinyLLaMA 等项目正推动 SLM 进入黄金时代。
7. MLM —— 掩码语言模型
MLM 是什么?
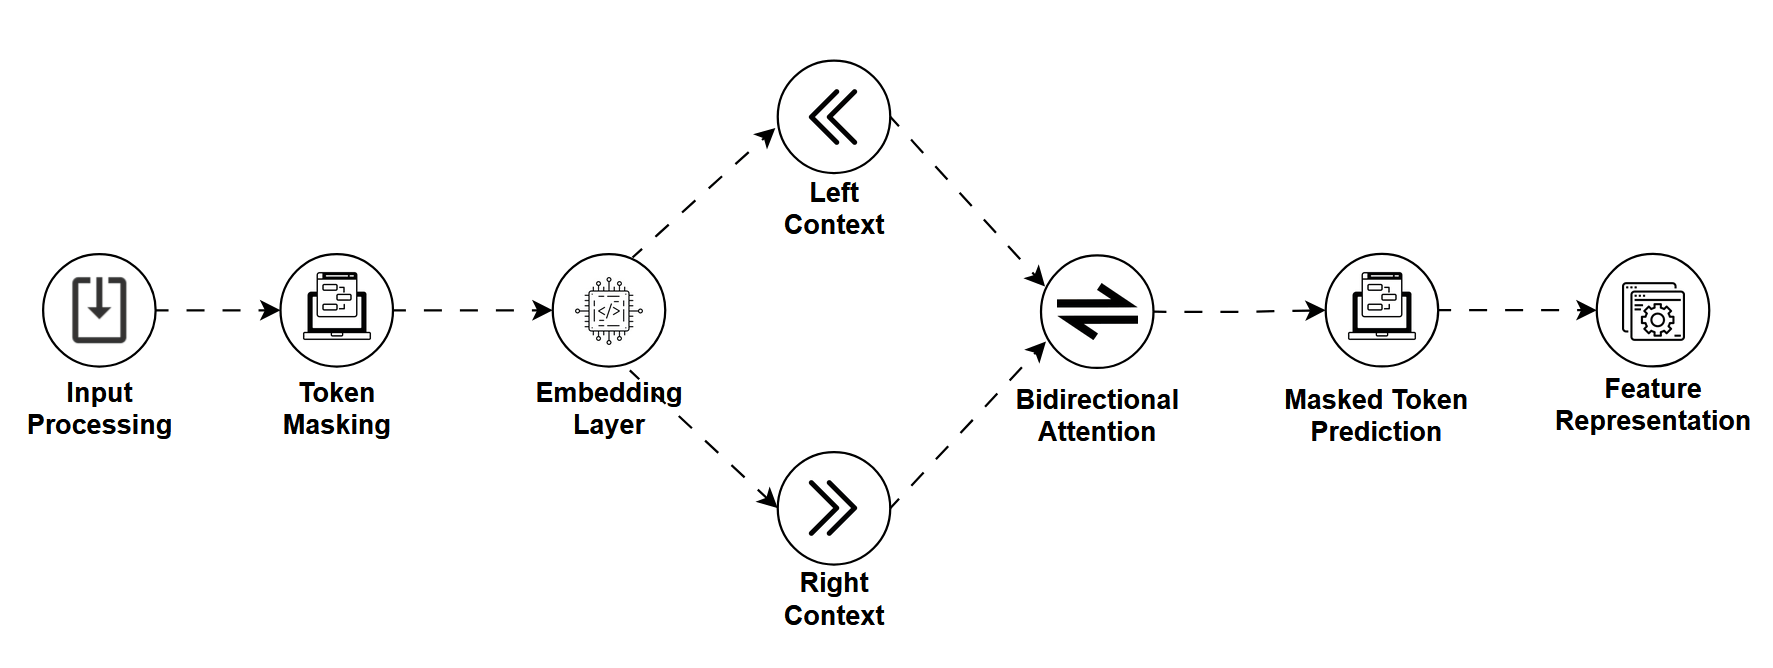
在 ChatGPT 席卷全球之前,BERT 开创了 MLM( Masked Language Model )时代。MLM 通过随机掩盖句子中的单词并预测缺失部分来训练,类似填空游戏,但能深度理解语言的语法、语义和双向上下文。
工作原理
例如,句子“埃菲尔铁塔位于 [MASK]”中,MLM 根据前后文预测“巴黎”。这种双向学习让 MLM 擅长:
- 语法结构
- 语义关系
- 上下文理解
MLM 通常在海量文本上预训练,再针对特定任务微调。
应用场景
- 搜索引擎(查询与结果的语义匹配)
- 文本分类(垃圾邮件检测、情感分析)
- 命名实体识别(识别姓名、日期、组织)
- 向量数据库的嵌入生成
- 其他模型的预训练基础
例如,搜索“附近便宜酒店”,MLM 能理解“便宜”指价格、“酒店”是住宿、“附近”与位置相关。
2025年的意义
尽管自回归模型(如 LLM)风头正劲,MLM 在需要双向理解、强上下文表示和低训练成本的场景中依然不可或缺。RoBERTa、DeBERTa 等优化版本进一步提升了其性能。
8. SAM —— 分割一切模型
SAM 是什么?

由 Meta AI 开发的 SAM( Segment Anything Model )是计算机视觉的革命性突破。不同于分类或检测整体物体的模型,SAM 能以像素级精度分割图像中的每个物体,即使是未见过的新物体。
工作原理
SAM 专为可提示分割设计。你提供一个提示(点、框或掩码),它就能精准分割指定物体。它使用:
- Vision Transformer 作为图像处理骨干
- 嵌入式方法比较视觉特征
- 快速分割解码器实时输出掩码
SAM 不局限于特定物体类别,而是“看懂”任何物体的形状和边界。
应用场景
- 医学影像:精准分割肿瘤或器官
- 增强现实( AR ):实时物体检测与掩码
- 机器人:帮助理解和交互环境
- 视频编辑:即时背景移除、物体隔离
- 科学研究:分割显微镜或卫星图像中的物体
例如,医学研究者只需点击 MRI 图像中的脑肿瘤,SAM 就能自动分割,无需手动描边或额外训练。
2025年的意义
SAM 的“零样本泛化”能力(对未见过物体有效)、实时性和模块化设计使其成为视觉 AI 的“乐高积木”。结合 VLM 或 LAM,SAM 推动了能“看懂”“理解”“行动”的下一代 AI 代理。
总结:选择适合的工具,迎接 AI 未来
从撰写文章的 LLM 到手机上的 SLM,再到像素级分割图像的 SAM,2025 年的 AI 生态远比“语言模型”丰富。每种模型——LLM、LCM、LAM、MoE、VLM、SLM、MLM、SAM——都是 AI 工具箱中的利器,针对特定领域和任务设计。
关键启示
- 选对模型:并非所有任务都需要 LLM。
- 理解架构:模型设计决定应用场景。
- 系统思维:未来是多模态、多代理和高度专业化的。
你对哪种 AI 模型最感兴趣?已经在开发,还是刚起步?欢迎分享你的想法、提问或探索方向。让我们一起学习,共同成长!
AI 的未来不仅属于专家,也属于像你一样的好奇心驱动者。保持大胆,持续探索,你的下一个创意可能改变一切!
